CPU 瓶颈解决思路
遇到 CPU 性能问题解决思路,先查看各种 CPU 指标
CPU 性能指标
CPU 使用率
- 用户 CPU 使用率,包括用户态 CPU 使用率(user)和低优先级用户态 CPU 使用率(nice),表示 CPU 在用户态运行的时间百分比。用户 CPU 使用率高,通常说明有应用程序比较繁忙。
- 系统 CPU 使用率,表示 CPU 在内核态运行的时间百分比(不包括中断)。系统 CPU 使用率高,说明内核比较繁忙。
- 等待 I/O 的 CPU 使用率,通常也称为 iowait,表示等待 I/O 的时间百分比。iowait 高,通常说明系统与硬件设备的 I/O 交互时间比较长。
- 软中断和硬中断的 CPU 使用率,分别表示内核调用软中断处理程序、硬中断处理程序的时间百分比。它们的使用率高,通常说明系统发生了大量的中断。
- 除了上面这些,还有在虚拟化环境中会用到的窃取 CPU 使用率(steal)和客户 CPU 使用率(guest),分别表示被其他虚拟机占用的 CPU 时间百分比,和运行客户虚拟机的 CPU 时间百分比。
平均负载
进程上下文切换
- 无法获取资源而导致的自愿上下文切换;
- 被系统强制调度导致的非自愿上下文切换。
CPU 缓存的命中率
L1、L2、L3 缓存命中率,衡量的是 CPU 缓存的复用情况,命中率越高,则表示性能越好。
性能工具
案例回顾
首先,平均负载的案例。我们先用 uptime, 查看了系统的平均负载;而在平均负载升高后,又用 mpstat 和 pidstat ,分别观察了每个 CPU 和每个进程 CPU 的使用情况,进而找出了导致平均负载升高的进程,也就是我们的压测工具 stress。
第二个,上下文切换的案例。我们先用 vmstat ,查看了系统的上下文切换次数和中断次数;然后通过 pidstat ,观察了进程的自愿上下文切换和非自愿上下文切换情况;最后通过 pidstat ,观察了线程的上下文切换情况,找出了上下文切换次数增多的根源,也就是我们的基准测试工具 sysbench。
第三个,进程 CPU 使用率升高的案例。我们先用 top ,查看了系统和进程的 CPU 使用情况,发现 CPU 使用率升高的进程是 php-fpm;再用 perf top ,观察 php-fpm 的调用链,最终找出 CPU 升高的根源,也就是库函数 sqrt() 。
第四个,系统的 CPU 使用率升高的案例。我们先用 top 观察到了系统 CPU 升高,但通过 top 和 pidstat ,却找不出高 CPU 使用率的进程。于是,我们重新审视 top 的输出,又从 CPU 使用率不高但处于 Running 状态的进程入手,找出了可疑之处,最终通过 perf record 和 perf report ,发现原来是短时进程在捣鬼。
另外,对于短时进程,我还介绍了一个专门的工具 execsnoop,它可以实时监控进程调用的外部命令。
第五个,不可中断进程和僵尸进程的案例。我们先用 top 观察到了 iowait 升高的问题,并发现了大量的不可中断进程和僵尸进程;接着我们用 dstat 发现是这是由磁盘读导致的,于是又通过 pidstat 找出了相关的进程。但我们用 strace 查看进程系统调用却失败了,最终还是用 perf 分析进程调用链,才发现根源在于磁盘直接 I/O 。
最后一个,软中断的案例。我们通过 top 观察到,系统的软中断 CPU 使用率升高;接着查看 /proc/softirqs, 找到了几种变化速率较快的软中断;然后通过 sar 命令,发现是网络小包的问题,最后再用 tcpdump ,找出网络帧的类型和来源,确定是一个 SYN FLOOD 攻击导致的。
根据指标找工具
| 性能指标 | 工具 | 说明 |
|---|---|---|
| 平均负载 | uptime top | uptime 最简单; top 提供了更全的指标 |
| 系统整体CPU使用率 | vmstat mpstat top sar /proc/stat | top、vmstat、mpstat 可以动态查看,而 sar 还可以记录历史数据;/proc/stat 是其他性能工具的数据来源 |
| 进程CPU使用率 | top pidstat ps htop atop | top 和 ps 可以按 CPU 使用率给进程排序,而 pidstat 只显示实际用了 CPU 的进程; htop 和 atop 以不同颜色显示更直观 |
| 系统上下文切换 | vmstat | 除了上下文切换次数,还提供运行状态和不中断状态进程的数量 |
| 进程上下文切换 | pidstat | 注意加上 -w 选项 |
| 软中断 | top /proc/softirqs mpstat | top 提供软中断 CPU 使用率, 而 /proc/softirqs 和 mpstat 提供了各种软中断在每个 CPU 上的运行次数 |
| 硬中断 | vmstat /proc/interrupts | vmstat 提供总的中断次数, 而 /proc/interrupts 提供各种中断在每个 CPU 上运行的累积次数 |
| 网络 | dstat sar tcpdump | dstat 和 sar 提供总的网络接收和发送情况, 而 tcpdump 则是动态抓取正在进行的网络通讯 |
| I/O | dstat sar | dstat 和 sar 都提供了 I/O 的整体情况 |
| CPU个数 | /proc/cpuinfo lscpu | lscpu 更直观 |
| 事件剖析 | perf execsnoop | perf 可以用来分析 CPU 的缓存以及内核调用链,execsnoop 用来监控短时进程 |
根据工具查指标
| 性能工具 | CPU性能指标 |
|---|---|
uptime | 平均负载 |
top | 平均负载、运行队列、整体的CPU使用率以及每个进程的状态和CPU使用率 |
htop | top增强版,以不同颜色区分不同类型的进程,更直观 |
atop | CPU、内存、磁盘和网络等各种资源的全面监控 |
vmstat | 系统整体的CPU使用率、上下文切换次数、中断次数,还包括处于运行和不可中断状态的进程数量 |
mpstat | 每个CPU的使用率和软中断次数 |
pidstat | 进程和线程的CPU使用率、中断上下文切换次数 |
/proc/softirqs | 软中断类型和在每个CPU上的累积中断次数 |
/proc/interrupts | 硬中断类型和在每个CPU上的累积中断次数 |
ps | 每个进程的状态和CPU使用率 |
pstree | 进程的父子关系 |
dstat | 系统整体的CPU使用率 |
sar | 系统整体的CPU使用率,包括可配置的历史数据 |
strace | 进程的系统调用 |
perf | CPU性能事件剖析,如调用链分析、CPU缓存、CPU频度等 |
execsnoop | 监控短时进程 |
指标关联性和原理
为了缩小排查范围,通常会先运行几个支持指标较多的工具,如 top、vmstat 和 pidstat。
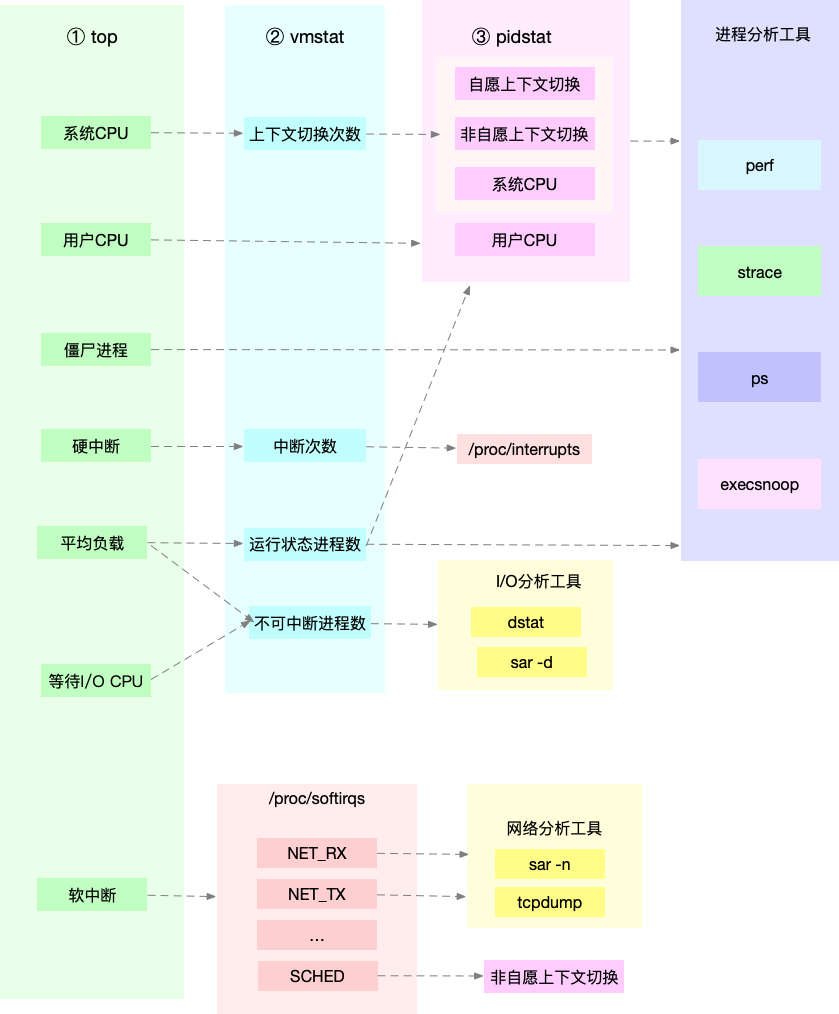
通过这张图你可以发现,这三个命令,几乎包含了所有重要的 CPU 性能指标,比如:
- 从 top 的输出可以得到各种 CPU 使用率以及僵尸进程和平均负载等信息。
- 从 vmstat 的输出可以得到上下文切换次数、中断次数、运行状态和不可中断状态的进程数。
- 从 pidstat 的输出可以得到进程的用户 CPU 使用率、系统 CPU 使用率、以及自愿上下文切换和非自愿上下文切换情况。
第一个例子,pidstat 输出的进程用户 CPU 使用率升高,会导致 top 输出的用户 CPU 使用率升高。所以,当发现 top 输出的用户 CPU 使用率有问题时,可以跟 pidstat 的输出做对比,观察是否是某个进程导致的问题。
而找出导致性能问题的进程后,就要用进程分析工具来分析进程的行为,比如使用 strace 分析系统调用情况,以及使用 perf 分析调用链中各级函数的执行情况。
第二个例子,top 输出的平均负载升高,可以跟 vmstat 输出的运行状态和不可中断状态的进程数做对比,观察是哪种进程导致的负载升高。
- 如果是不可中断进程数增多了,那么就需要做 I/O 的分析,也就是用 dstat 或 sar 等工具,进一步分析 I/O 的情况。
- 如果是运行状态进程数增多了,那就需要回到 top 和 pidstat,找出这些处于运行状态的到底是什么进程,然后再用进程分析工具,做进一步分析。
最后一个例子,当发现 top 输出的软中断 CPU 使用率升高时,可以查看 /proc/softirqs 文件中各种类型软中断的变化情况,确定到底是哪种软中断出的问题。比如,发现是网络接收中断导致的问题,那就可以继续用网络分析工具 sar 和 tcpdump 来分析。
CPU 性能优化手段
应用优化
- 编译器优化:很多编译器都会提供优化选项,适当开启它们,在编译阶段你就可以获得编译器的帮助,来提升性能。比如, gcc 就提供了优化选项 -O2,开启后会自动对应用程序的代码进行优化。
- 算法优化:使用复杂度更低的算法,可以显著加快处理速度。比如,在数据比较大的情况下,可以用 O(nlogn) 的排序算法(如快排、归并排序等),代替 O(n^2) 的排序算法(如冒泡、插入排序等)。
- 异步处理:使用异步处理,可以避免程序因为等待某个资源而一直阻塞,从而提升程序的并发处理能力。比如,把轮询替换为事件通知,就可以避免轮询耗费 CPU 的问题。
- 多线程代替多进程:前面讲过,相对于进程的上下文切换,线程的上下文切换并不切换进程地址空间,因此可以降低上下文切换的成本。
- 善用缓存:经常访问的数据或者计算过程中的步骤,可以放到内存中缓存起来,这样在下次用时就能直接从内存中获取,加快程序的处理速度。
系统优化
- CPU 绑定:把进程绑定到一个或者多个 CPU 上,可以提高 CPU 缓存的命中率,减少跨 CPU 调度带来的上下文切换问题。
- CPU 独占:跟 CPU 绑定类似,进一步将 CPU 分组,并通过 CPU 亲和性机制为其分配进程。这样,这些 CPU 就由指定的进程独占,换句话说,不允许其他进程再来使用这些 CPU。
- 优先级调整:使用 nice 调整进程的优先级,正值调低优先级,负值调高优先级。优先级的数值含义前面我们提到过,忘了的话及时复习一下。在这里,适当降低非核心应用的优先级,增高核心应用的优先级,可以确保核心应用得到优先处理。
- 为进程设置资源限制:使用 Linux cgroups 来设置进程的 CPU 使用上限,可以防止由于某个应用自身的问题,而耗尽系统资源。
- NUMA(Non-Uniform Memory Access)优化:支持 NUMA 的处理器会被划分为多个 node,每个 node 都有自己的本地内存空间。NUMA 优化,其实就是让 CPU 尽可能只访问本地内存。
- 中断负载均衡:无论是软中断还是硬中断,它们的中断处理程序都可能会耗费大量的 CPU。开启 irqbalance 服务或者配置 smp_affinity,就可以把中断处理过程自动负载均衡到多个 CPU 上。